Sécuriser un agent IA avec Docker : sandbox, capabilities et network isolation
Dans mon précédent article, j’expliquais pourquoi donner un shell à un agent IA est dangereux. La conclusion était claire : si vous devez le faire, mettez-le dans un sandbox. Cet article est le complément pratique : comment construire ce sandbox avec Docker, en allant bien au-delà du simple docker run.
L’idée de base est séduisante : un agent IA qui peut exécuter du code, mais dans un container éphémère, sans accès à l’hôte, avec des ressources limitées. En théorie, même si l’agent est compromis via un prompt injection, les dégâts sont contenus dans le container. En pratique, ça marche, mais seulement si on durcit correctement chaque couche. Un docker run basique ne suffit pas.
Le principe fondamental
Le container Docker n’est pas un sandbox par défaut. C’est un espace de noms (namespace) isolé, avec un cgroup pour les limites de ressources et une configuration de sécurité optionnelle. Par défaut, un container a :
- Un accès réseau (même bridge)
- Des capabilities Linux qui permettent des opérations sensibles
- Un filesystem qui persiste entre les exécutions
- Un accès potentiellement à l’hôte via les volumes montés
Tout cela doit être durci pour qu’un agent IA ne puisse pas s’échapper.
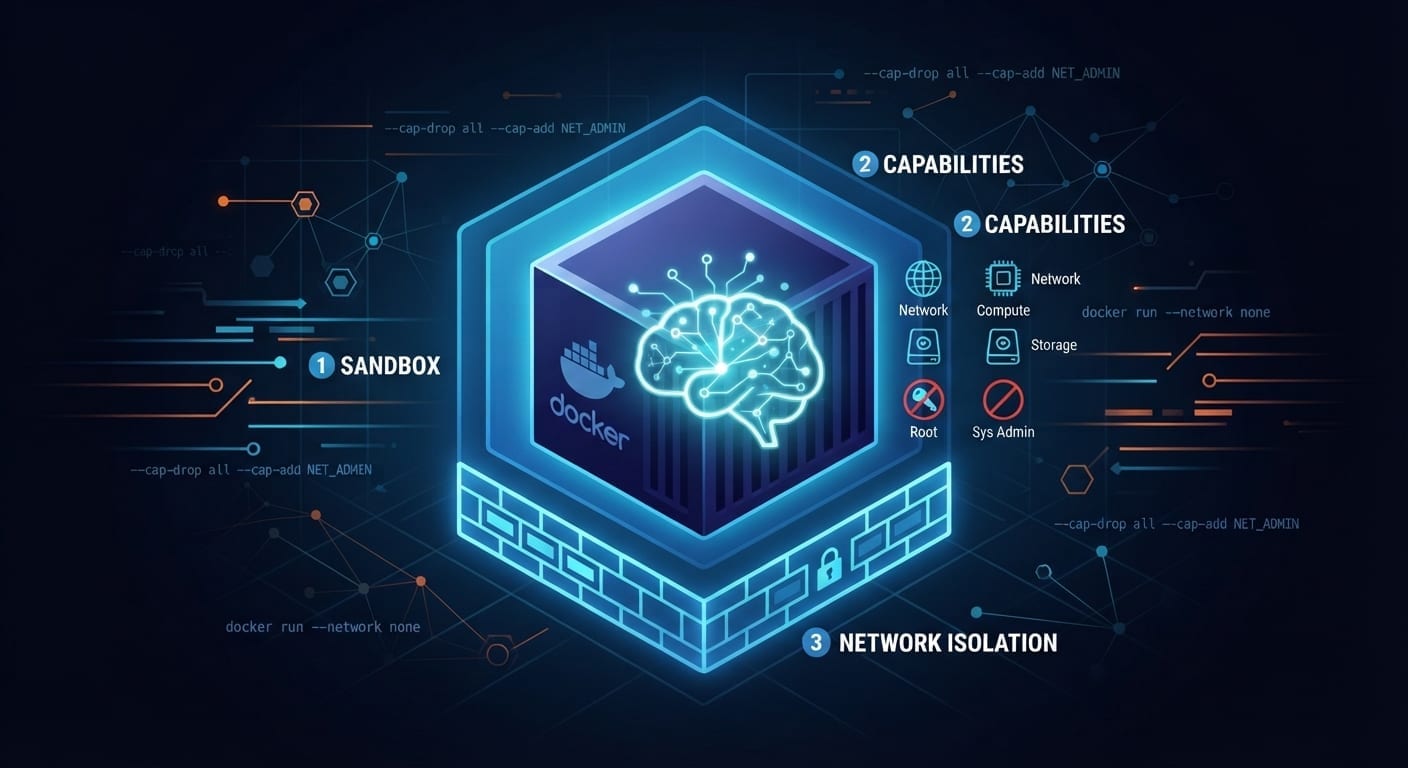
Voici le flux de sécurité que nous allons construire :
Le docker run complet
Voici la commande complète avec toutes les options de durcissement. On la détaillera couche par couche après.
docker run --rm \ |
Chaque flag a un rôle précis. Regardons-les un par un.
Layer 1 : les capabilities Linux
Linux définit un ensemble de “capabilities” qui décomposent le privilege root en unités granulaires. Par défaut, Docker en conserve un sous-ensemble. On fait l’inverse : on retire tout (--cap-drop ALL) puis on n’ajoute que ce qui est strictement nécessaire.
--cap-drop ALL \ |
Pourquoi ces trois-là ?
SETUID/SETGID: nécessaires si le container doit changer d’utilisateur (par ex. pour exécuter du code comme un utilisateur non-root mais avec besoin de changer d’identité). Beaucoup de runtimes de langages en ont besoin.SYS_CHROOT: nécessaire pour certains environnements sandboxés internes (par ex.bubblewrapoufirejailà l’intérieur du container).
Toute autre capability est un risque inutile. Voici un tableau des capabilities dangereuses et pourquoi on les retire :
| Capability | Permet | Pourquoi c’est dangereux pour un agent |
|---|---|---|
SYS_ADMIN |
Montage de filesystems, etc. | Évasion de sandbox |
NET_ADMIN |
Configuration réseau | Contourner network isolation |
SYS_PTRACE |
Attachement à des processus | Injection dans d’autres containers |
SYS_MODULE |
Chargement de modules noyau | Compromission de l’hôte |
DAC_READ_SEARCH |
Lecture de fichiers root | Accès aux secrets de l’hôte |
SYS_RAWIO |
I/O direct hardware | Compromission matérielle |
SYS_TIME |
Modification de l’horloge | Contourner des mécanismes temporels |
NET_RAW |
Raw sockets | Sniffing réseau, attaques réseau |
Layer 2 : le filesystem en lecture seule
Le filesystem du container est monté en lecture seule. L’agent ne peut écrire nulle part, sauf dans les emplacements explicitement autorisés :
--read-only \ |
--read-only: le root filesystem du container est immuable. L’agent ne peut pas modifier les binaires, installer des paquets, ou écrire des scripts malveillants dans le filesystem.--tmpfs /tmp: un filesystem temporaire en mémoire, monté avecnoexec(pas d’exécution de binaires),nosuid(pas de bits setuid), et une taille limite de 64 Mo. C’est l’espace d’écriture de l’agent, mais il ne persiste pas et il est limité.--tmpfs /var/tmp: idem pour/var/tmp, avec 32 Mo.
Pourquoi noexec sur tmpfs ? Parce qu’un agent compromis pourrait télécharger un binaire via curl (si le réseau était autorisé) et l’exécuter depuis /tmp. Avec noexec, cette tentative échoue. L’agent peut écrire des fichiers dans /tmp mais pas les exécuter.
Layer 3 : l’isolation réseau
C’est la couche la plus critique. Un agent avec accès réseau peut exfiltrer des données, contacter des serveurs Command & Control, ou attaquer d’autres services.
--network none |
--network none supprime totalement l’accès réseau du container. Pas d’interface réseau, pas de résolution DNS, pas de communication possible avec l’extérieur. L’agent ne peut lire que les fichiers qui sont montés dans le container.
L’alternative : réseau restreint avec proxy
Parfois, l’agent a besoin d’un accès réseau limité (par ex. pour appeler une API). Dans ce cas, on utilise un réseau restreint avec un proxy d’autorisation :
# docker-compose.yml |
Le proxy filtre les requêtes sortantes. Seules les URLs explicitement autorisées sont accessibles. Tout le reste est bloqué. C’est plus complexe que --network none mais c’est parfois nécessaire.
# tinyproxy.conf |
Layer 4 : les limites de ressources
Un agent compromis peut consommer toutes les ressources de l’hôte en lançant des boucles infinies ou des calculs intensifs. Les cgroups empêchent cela :
--memory 256m \ |
--memory 256m: le container ne peut pas utiliser plus de 256 Mo de RAM. Au-delà, le kernel tue le processus (OOM kill).--cpus 1.0: le container est limité à un coeur CPU. Il ne peut pas saturer l’hôte.--pids-limit 128: le container ne peut pas créer plus de 128 processus. Cela empêche les fork bombs et les attaques par déni de ressources.
Pourquoi 256 Mo ? C’est un compromis. Suffisamment pour exécuter la plupart des scripts Python/Node.js simples, mais pas assez pour entraîner un modèle ou faire du minage de crypto. Ajustez selon vos besoins, mais ne jamais laisser de limite par défaut (qui est la mémoire illimitée).
Layer 5 : no-new-privileges et seccomp
--security-opt no-new-privileges \ |
no-new-privileges empêche un processus dans le container d’acquérir de nouveaux privilèges via setuid/setgid. Même si le binaire exécuté a le bit setuid, le processus ne bénéficiera pas des privilèges élevés.
seccomp (Secure Computing) restreint les appels système autorisés. Le kernel de Linux définit des centaines d’appels système. Un agent n’en a besoin que d’une poignée. Le profile seccomp bloque tout le reste.
Voici un exemple de profile seccomp pour un agent d’exécution de code :
{ |
Le defaultAction est ERRNO (erreur silencieuse) pour tous les appels système non listés. Seuls les appels explicitement autorisés passent. C’est la couche la plus profonde de la défense.
Le Dockerfile du sandbox
Le container doit être minimaliste. Plus il y a de binaires, plus la surface d’attaque est grande.
FROM python:3.12-slim AS runtime |
Points importants :
python:3.12-slim: image minimale, pas de compilation outils, pas de paquets inutiles.- Utilisateur non-root : le processus tourne en tant que
sandbox:1000, pas root. Même si l’agent trouve une faille d’évasion de namespace, il est non-root dans le container. - Pas de
curl,wget,nc: ces outils sont absents de l’image de base. Un agent compromis ne peut pas facilement télécharger du code malveillant ou ouvrir des connexions sortantes. - ENTRYPOINT minimal : le container exécute uniquement le script demandé.
Le docker-compose complet
Pour un agent IA avec un sandbox dédié, voici l’architecture docker-compose :
services: |
Deux réseaux distincts :
agent-net: l’agent communique avec Redis et les APIs externes.sandbox-net: le sandbox communique avec l’agent mais n’a pas accès à l’extérieur. Le flaginternal: trueempêche toute connexion sortante.
L’agent orchestre, le sandbox exécute. Séparation nette des responsabilités.
Le tableau de durcissement
Récapitulons chaque couche de sécurité et ce qu’elle empêche :
| Couche | Flag Docker | Attaque empêchée |
|---|---|---|
| Capabilities | --cap-drop ALL |
Évasion de namespace, accès kernel |
| Filesystem | --read-only |
Modification de binaires, installation de malware |
| Exécution | --tmpfs noexec |
Exécution de binaires depuis /tmp |
| Réseau | --network none |
Exfiltration de données, C&C |
| Mémoire | --memory 256m |
OOM, déni de service mémoire |
| CPU | --cpus 1.0 |
Saturation CPU, fork bombs |
| Processus | --pids-limit 128 |
Fork bombs, déni de service |
| Privileges | no-new-privileges |
Escalade de privilèges via setuid |
| Appels système | seccomp=strict |
Accès aux fonctions kernel dangereuses |
| Utilisateur | --user 1000:1000 |
Action en tant que root dans le container |
| Éphémérité | --rm |
Persistance de données entre les exécutions |
Le cycle de vie d’un code sandboxé
Voici comment un agent IA exécute du code de manière sécurisée :
- L’utilisateur demande “écris un script Python pour analyser ce CSV”.
- L’agent génère le code.
- L’orchestrateur crée le container éphémère avec toutes les options de sécurité.
- Le code est monté en lecture seule dans le container (ou copié dans /tmp).
- Le container exécute le code avec l’utilisateur non-root.
- La sortie (stdout/stderr) est capturée.
- Le container est détruit (
--rm). - L’orchestrateur retourne la sortie à l’agent, qui la présente à l’utilisateur.
# Étape 3-7 : exécution sandboxée |
Le script est monté en lecture seule (:ro). Le container ne peut pas le modifier. La sortie est capturée par l’orchestrateur via docker logs ou redirection de stdout.
Les pièges courants
Le piège du docker-in-docker
Si votre agent tourne déjà dans un container (par ex. dans Kubernetes), lancer des containers sandbox depuis ce container nécessite docker-in-docker ou un accès au socket Docker de l’hôte. Monter le socket Docker (-v /var/run/docker.sock:/var/run/docker.sock) est une faille de sécurité critique : le container peut devenir root sur l’hôte. Ne jamais faire ça dans un contexte de sandbox.
La solution : un serveur dédié qui reçoit les requêtes d’exécution et les lance dans des containers. L’agent communique avec ce serveur via une API, pas directement avec Docker.
Le piège du persistent volume
Un volume persistant entre les exécutions permet à un agent compromis de stocker du code malveillant pour une exécution future. Utilisez toujours des volumes éphémères ou des tmpfs. Si vous devez conserver des données entre les exécutions, stockez-les dans un service externe (base de données, objet storage) avec des politiques d’accès strictes.
Le piège du filesystem monté en écriture
Monter un répertoire de l’hôte en écriture dans le container, même avec un chemin spécifique, donne à l’agent la capacité de modifier des fichiers de l’hôte. Si vous devez monter des fichiers, faites-le en lecture seule (:ro). Si vous devez permettre l’écriture, utilisez un tmpfs ou un volume dédié non monté sur l’hôte.
Monitoring et audit
Un sandbox sans monitoring est un sandbox aveugle. Quand un agent est compromis, vous devez pouvoir le détecter et l’analyser.
# Logs de tous les containers sandbox |
En production, connectez ces logs à un système d’alerte. Un container qui consomme 100% de sa mémoire, qui tente des appels système refusés par seccomp, ou qui génère beaucoup de processus est un signal d’alerte.
Pour aller plus loin
Ce durcissement Docker est un excellent point de départ, mais pour des cas d’usage plus exigeants, voici les pistes :
- gVisor : un noyau utilisateur qui intercepte les appels système. Couche supplémentaire au-dessus de Docker, avec un model sandbox encore plus strict.
- Firecracker : des microVMs pour un isolation encore plus forte. Utilisé par AWS Lambda.
- eBPF : des policies de sécurité dynamiques au niveau du noyau, pour surveiller et contrôler le comportement des containers en temps réel.
- Sysbox : un runtime OCI qui renforce l’isolation des containers sans les limitations de performance des VMs.
Le Docker durci n’est pas la solution ultime, mais c’est le meilleur rapport effort/sécurité pour la majorité des cas d’usage d’agents IA. L’important est de comprendre chaque couche, de savoir ce qu’elle protège, et de ne jamais considérer le sandbox comme magique. La sécurité est un processus, pas un état.