Logs vs metrics vs traces : enfin comprendre la différence
Je vois encore beaucoup de confusion autour des trois piliers de l’observabilité : les logs, les métriques et les traces. On utilise souvent le mot “monitoring” pour tout, et on finit par instrumenter n’importe comment. Dans cet article, je mets enfin les choses au clair : ce que sont ces trois types de données, ce qu’ils mesurent chacun, quand les utiliser, et comment ils se complètent.
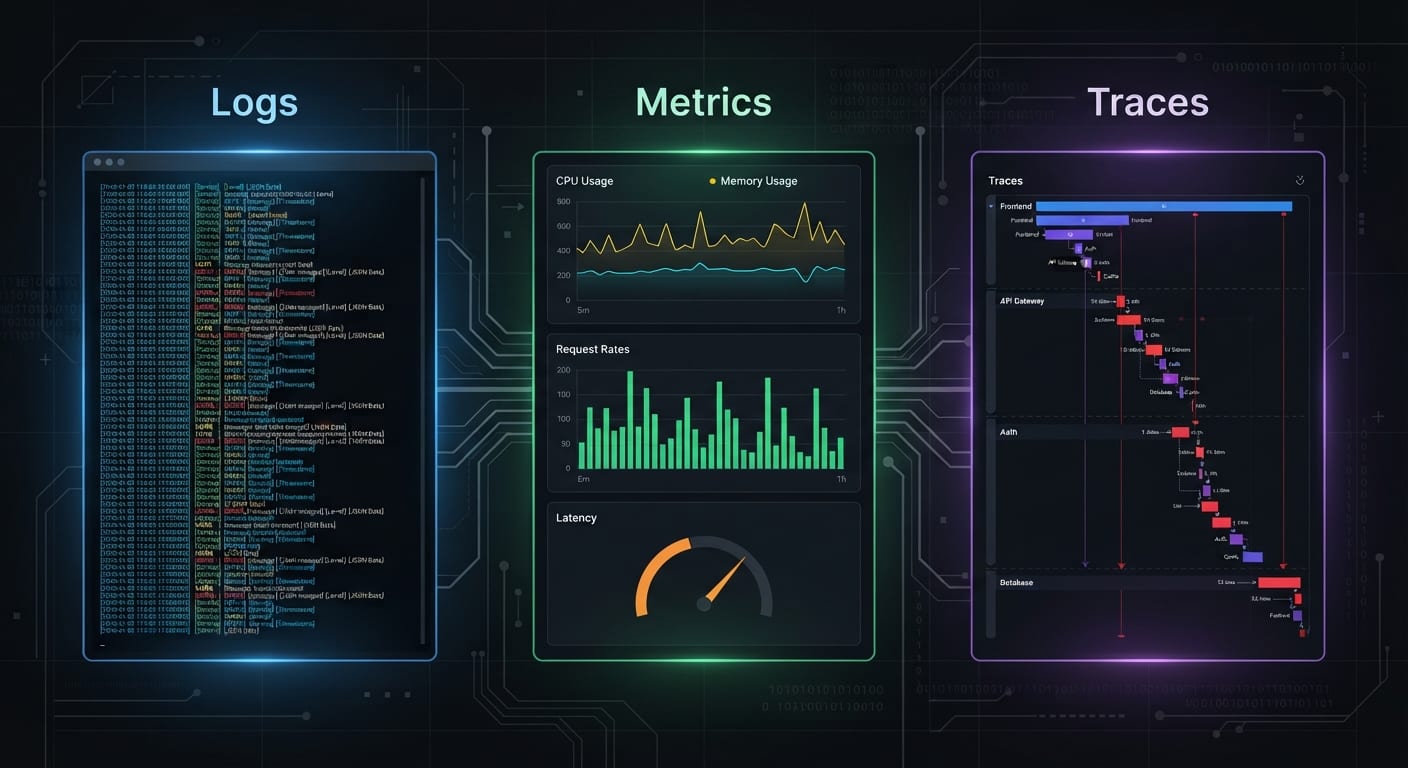
La clé tient en une phrase : ce sont trois angles de vue différents sur le même système. Le log dit ce qui s’est passé, la métrique dit combien de fois et en combien de temps, la trace dit par où est passé le temps. Ce ne sont pas des concurrents, ce sont des vues complémentaires qu’on corrèle.
Les logs : des événements discrets
Un log est un événement discret daté. Il répond à la question “que s’est-il passé à cet instant précis ?”. C’est le type de donnée le plus ancien et le plus simple à comprendre : une ligne, ou un objet JSON, qui décrit un fait.
2026-12-12T09:01:22.184Z INFO user=42 action=login ip=203.0.113.5 |
Les caractéristiques fondamentales des logs :
- Riches et descriptifs : ils portent du contexte, des valeurs, des messages. On peut y retrouver un
user_id, une erreur, un détail métier. - Non structurés ou semi-structurés : dans le meilleur des cas JSON (recommandé), mais parfois juste du texte libre.
- Volumineux et peu compactés : un service actif produit des millions de logs par jour, il faut de gros volumes de stockage et du filtrage efficace.
- Pas natifs à l’agrégation : pour connaître un compte (combien d’erreurs ?), il faut compter des lignes, ce qui est coûteux.
Le log est la source de détail : quand quelque chose a mal tourné, c’est lui qui contient le pourquoi granulaire. Mais il est mauvais pour la vue d’ensemble.
Quand utiliser les logs : le diagnostic fin, le débogage, la conformité (audit), la recherche d’une occurrence précise avec un grep sémantique. Si vous devez répondre à “montre-moi tout ce qui s’est passé pour cet utilisateur”, vous voulez des logs.
Les métriques : des agrégations numériques
Une métrique est une mesure numérique agrégée sur le temps. Elle répond à la question “combien ?” ou “en combien de temps ?”. C’est une série de points (valeur, horodatage), souvent taguée par des labels.
Une métrique est native à la série temporelle : elle est conçue pour être agrégée, moyennée, passée en percentile, affichée en graphe. C’est le contraire du log.
Il existe trois grands types de métriques :
- Compteur (counter) : une valeur qui ne fait que croître (nombre total de requêtes, de tokens, d’erreurs). Pour obtenir un débit, on calcule sa dérivée (
rate). - Jauge (gauge) : une valeur qui monte et descend (température, profondeur de file, nombre de connexions actives). Couramment mesurée à l’instant T.
- Histogramme (histogram) : une distribution de valeurs (temps de réponse) dont on dérive les percentiles p50, p95, p99.
Exemple de séries de métriques :
http_requests_total{method="GET",status="200"} 1024 # compteur |
Les caractéristiques clés :
- Compactes et bon marché : une métrique occupe quelques octets, contrairement à un log. On peut les conserver très longtemps.
- Optimisées pour l’agrégation : le graphe, l’alerte, le tableau de bord sont leur terrain de jeu naturel.
- Pauvres en contexte : une métrique vous dit “500 erreurs” mais pas “pour tel utilisateur, avec telle erreur”. Le label donne un contexte limité, rien de plus.
La métrique est la source de tendance et d’alerte : elle répond à “le système va-t-il bien en ce moment ?” et constitue la base de tous les dashboards et alertes.
Quand utiliser les métriques : la surveillance continue, les alertes, la capacité, l’analyse de tendance, le coût. Si vous devez répondre à “quelle est la latence moyenne et le taux d’erreur de ce service cette semaine”, vous voulez des métriques.
Les traces : le cycle de vie d’une requête
Une trace décrit le cycle de vie d’une requête à travers les services. Elle répond à la question “où est passé le temps ?”. C’est l’outil des architectures distribuées.
Une trace est composée de spans : chaque span représente une unité de travail (un appel HTTP, une requête de base de données, un appel de service externe) avec son nom, sa durée, son début et sa fin. Les spans sont hiérarchiques : un span parent (la requête initiale) contient des spans enfants (chaque appel effectué pour la servir).
Trace: GET /orders/42 |
Les caractéristiques clés :
- Hiérarchique : montre la relation parent-enfant entre les étapes.
- Corrélée par un identifiant : chaque span porte un
trace_idpartagé, qui relie tous les spans d’une même requête, même à travers les services. - Conçue pour mesurer le temps : d’où le temps de chaque étape, indispensable pour le profilage.
La trace est la source de parcours et de diagnostic de latence : elle répond à “pourquoi cette requête précise était lente, et où est passé le temps ?”. Une trace révèle qu’un service que vous ne soupçonniez pas (et non le plus chargé) est le vrai goulot d’étranglement.
Quand utiliser les traces : le diagnostic de latence end-to-end, le profilage distribué, l’analyse d’une requête spécifique lente. Si vous devez répondre à “où a passé le temps cette requête qui a mis 5 secondes ?”, vous voulez des traces.
Le problème de cardinalité
Un concept central pour choisir où mettre une donnée est la cardinalité, c’est-à-dire le nombre de valeurs distinctes que peut prendre un identifiant.
Prenons l’exemple d’un user_id. Il y a des millions de valeurs possibles distinctes. Si vous en faites un label de métrique, chaque valeur distincte crée une nouvelle série temporelle, et le nombre de séries explose à l’échelle. C’est le célèbre problème de cardinalité de Prometheus : il faut limiter les labels à basse cardinalité (méthode HTTP, statut, nom de service) et ne jamais y mettre d’identifiants à haute cardinalité (user_id, request_id, IP).
La règle que je suis :
- Haute cardinalité (user_id, request_id, transaction id) → logs : le log est fait pour ça, il n’a aucun problème à contenir un identifiant distinct par ligne.
- Basse cardinalité (status, method, model, tool, region) → métriques : parfait comme label.
- Traces : un compromis, le
trace_idest de haute cardinalité mais vit dans les spans, pas dans des labels de métrique.
Si vous connaissez le concept de cardinalité, vous comprenez pourquoi on ne peut pas tout mettre dans les métriques : ça exploserait le stockage. D’où la complémentarité logique entre logs et métriques.
Comment ils se complètent : la corrélation
Les trois piliers ne prennent tout leur sens que corrélés. L’idée maîtresse est de pouvoir passer d’une vue à l’autre sans perdre le fil d’une même requête.
La façon la plus simple de corréler est d’ajouter le même identifiant partout. Une requête reçoit un trace_id (et un request_id). Ce même identifiant est :
- ajouté à chaque log généré pendant la requête (en champ JSON),
- visible dans les spans de la trace,
- et, si besoin, référencé dans une métrique pour y accéder.
Ainsi, on peut partir d’un graphe de métriques (le p99 de latence grimpe), cliquer pour voir les traces lentes de la période, prendre une trace, et de là ouvrir les logs correspondants. C’est exactement le workflow que je décris dans mon article sur OpenTelemetry. La corrélation est le ciment des trois piliers.
Un exemple complet : une seule requête
Prenons un exemple concret pour montrer comment une seule requête utilisateur génère des logs, met à jour des métriques, et construit une trace. L’utilisateur clique “panier” sur une boutique en ligne, ce qui appelle le service de commande, qui lui-même appelle la base de données et un service de paiement externe.
La trace
Une trace unique est créée, avec un trace_id (par exemple abc123). Elle contient des spans hiérarchiques :
Trace: abc123 — POST /orders |
Chaque span porte un identifiant de parent, ce qui reconstitue l’arbre. C’est la trace qui montre que les 60 ms de paiement sont le plus gros poste, et qu’en les regardant de plus près, 55 ms sont passées dans l’appel HTTP externe, pas dans votre code.
Les logs générés
Le long de cette requête, plusieurs logs sont émis, chacun tagué avec le trace_id :
2026-12-12T09:02:01.001Z INFO trace=abc123 svc=orders event="order_received" order_id=7741 |
Ces logs contiennent des détails que ni la trace ni les métriques ne portent : l’order_id, le gateway, le montant. Si le paiement échoue, c’est dans un log qu’on trouvera le code d’erreur exact du prestataire, corrélé à la trace par le trace_id.
Les métriques mises à jour
Pendant ce temps, les mêmes événements incrémentent des métriques agrégées. Plusieurs compteurs et jauges changent :
orders_total{status="success"} +1 # compteur |
Ces métriques ne contiennent ni trace_id, ni order_id : elles ont une cardinalité basse (statut, gateway, service). Elles ne savent pas quelle commande précise, mais elles permettent de répondre “combien de commandes réussies cette heure ? à quelle latence ?” de façon extrêmement bon marché.
Le tableau de synthèse
| Type | Question répondu | Cardinalité | Coût de stockage | Usage principal |
|---|---|---|---|---|
| Logs | Que s’est-il passé ? | Haute (OK) | Élevé | Diagnostic fin, débogage, audit |
| Métriques | Combien / en combien de temps ? | Basse (label) | Faible | Dashboards, alertes, tendances |
| Traces | Où est passé le temps ? | Haute (trace_id) | Moyen | Profilage distribué, latence end-to-end |
En résumé, pour cette requête unique : la trace la reconstitue de bout en bout, les logs enrichissent chaque étape de détails métier, et les métriques glissent une goutte dans le grand réservoir numérique qui alimente les graphes. Ce ne sont pas trois systèmes concurrents, c’est trois regards sur le même événement.
Les pièges à éviter
Voici les erreurs que je répète avoir vues, et comment les éviter.
Mettre des métriques partout
Le piège inverse : vouloir tout mesurer en métrique, y compris les détails riches. On finit avec des labels à haute cardinalité (user_id dans un label) et un stockage qui explose, ou des métriques illisibles qui ne disent rien de précis.
Remède : métriques pour les tendances à faible cardinalité, logs pour le détail. Si vous avez besoin du détail d’une occurrence, c’est un log, pas une métrique.
Faire de la traçage excessif sur un monolithe
Pour une application monolithique sur un seul processus, les traces apportent peu : il n’y a pas de frontière de service à traverser, et la latence se diagnostique très bien avec des logs horodatés et des métriques. Ajouter toute la mécanique de traçage distribué (span contextes, traçage propagé) est un surcoût sans bénéfice.
Remède : sur un monolithe, loguez avec soin, mesurez les métriques de latence, et oubliez les traces tant qu’il n’y a pas de vrai service séparé. La trace devient indispensable quand vous avez plusieurs services qui s’appellent entre eux.
Des logs sans corrélation
Des logs volumineux mais sans trace_id ni request_id commun sont quasi inexploitables pour une requête qui traverse plusieurs services : impossible de reconstituer le fil.
Remède : propagez systématiquement un identifiant commun (request_id / trace_id) dans tous les logs et tous les spans d’une même requête. C’est la condition pour que la corrélation fonctionne.
Des alertes basées uniquement sur les logs
Compter des lignes de log pour alerter est lent et peu fiable (le volume, le format, la perte de ligne affectent le résultat). Les alertes doivent reposer sur des métriques, qui sont conçues pour ça.
Remède : les logs pour le diagnostic après coup, les métriques pour l’alerte temps réel.
Réflexion finale
La compréhension de la différence entre les trois piliers m’a permis de construire des systèmes d’observabilité cohérents au lieu d’un tas d’outils empilés. La règle simple que je retiens : métriques pour voir, logs pour comprendre, traces pour retrouver. Chaque outil à sa place, et la corrélation relie le tout.
Si je ne devais en garder qu’une idée, ce serait celle-ci : ne choisissez pas logs ou métriques comme si c’étaient des concurrents. Posez-vous la question : quelle question est-ce que je veux pouvoir répondre ? Choisissez l’outil adapté, sachant que la plupart des bonnes réponses exigeront de mélanger deux, voire trois piliers, reliés par un identifiant commun.
Pour aller plus loin
- OpenTelemetry unifie logs, métriques et traces dans un même kit d’instrumentation (article dédié).
- Les metrics d’un LLM : appliquer ces principes aux applications IA (article dédié).
- Visualisation : une fois les métriques en place, construire un dashboard Grafana.
- Grafana Tempo, Loki et Prometheus : respectivement traces, logs et métriques, souvent déployés ensemble dans la pile Grafana.